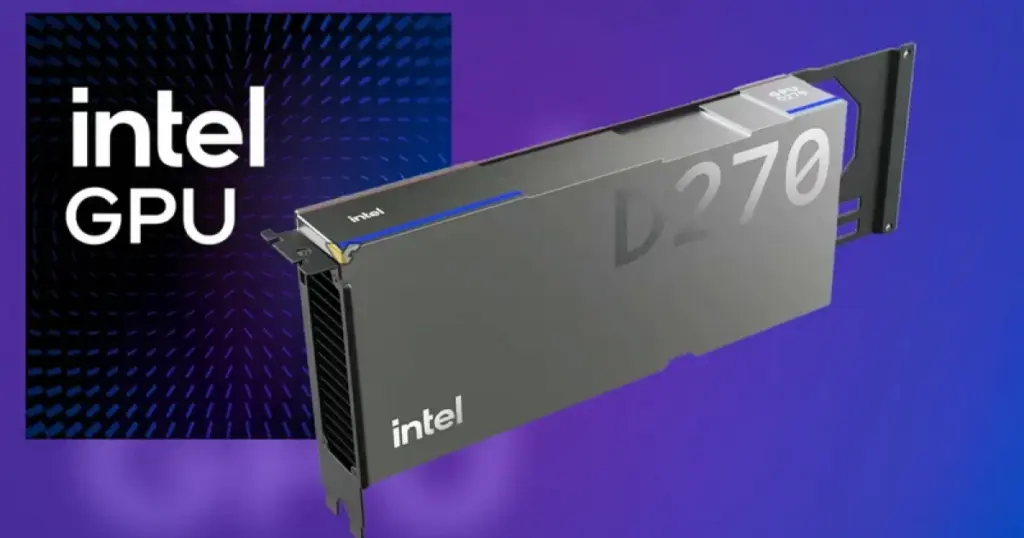
- Intel официально анонсировала линейку ускорителей GPU D-Series на базе архитектуры Xe3P, флагманом которой стал чип GPU D270 (ранее Crescent Island).
- Устройство получило до 480 ГБ энергоэффективной памяти LPDDR5X с пропускной способностью 1,5 ТБ/с и пиковую FP8-производительность 1,3 PFLOPS при TDP 350 Вт с воздушным охлаждением.
- Новинка ориентирована на центры обработки данных и облачные сервисы для обслуживания моделей с более чем 1 триллионом параметров без перехода на жидкостное охлаждение.
На отраслевом саммите Open Compute Project (OCP) 2026 корпорация Intel официально раскрыла детали проекта, ранее известного под кодовым именем Crescent Island. Продукт получил коммерческое обозначение GPU D-Series, а на официальном ресурсе производителя дебютировала конкретная модификация — Intel GPU D270. Чип разработан специально для задач инференса искусственного интеллекта и полностью лишен классических аппаратных блоков 3D-графики и трассировки лучей.
Архитектура Xe3P и ставка на LPDDR5X
Основой нового ускорителя выступает микроархитектура Xe3P. Фактически Intel трансформировала графическую структуру в массивный параллельный вычислительный процессор для рабочих нагрузок инференса. Главной конструктивной особенностью стало использование памяти LPDDR5X совокупным объемом до 480 ГБ вместо дорогостоящей и дефицитной многослойной памяти HBM, которая применялась в предшественнике Gaudi 3 (128 ГБ HBM).
Такой подход обеспечивает пропускную способность подсистемы памяти на уровне 1,5 ТБ/с. При этом вычислительная мощность решения в формате низкой точности FP8 достигает 1,3 PFLOPS. Вся система выполнена в стандартном форм-факторе платы расширения PCIe с теплопакетом (TDP) 350 Вт, что позволяет использовать традиционное воздушное охлаждение и интегрировать платы в уже существующую инфраструктуру дата-центров.
| Характеристика | Intel GPU D270 (D-Series) | Intel Gaudi 3 (предыдущее поколение) |
|---|---|---|
| Архитектура | Xe3P (инференс) | Gaudi |
| Тип памяти | LPDDR5X | HBM2e / HBM |
| Максимальный объем памяти | До 480 ГБ | 128 ГБ |
| Пропускная способность памяти | 1,5 ТБ/с | Высокая (многоканальный HBM) |
| Пиковая производительность FP8 | 1,3 PFLOPS | — |
| TDP и охлаждение | 350 Вт (воздушное) | До 600–900 Вт (зависит от исполнения) |
| Форм-фактор | Стандартный PCIe | OAM / PCIe |
Масштабирование и работа со сверхбольшими нейросетями
По заявлению представителей Intel, серверные узлы с воздушным охлаждением способны вмещать до восьми ускорителей GPU D-Series. Подобный кластер ориентирован на обслуживание комплексных архитектур, включая масштабные языковые модели с объемом свыше 1 триллиона параметров, обработку длинного контекста и задачи с жесткими требованиями к задержкам.
Для эффективного исполнения задач в корпоративной среде компании требуется слаженная программная экосистема. Intel опирается на единый программный базис OneAPI и платформу Xe, охватывающую интегрированную и дискретную графику. Как отметил вице-президент Intel по ИИ-продуктам Анил Нандури, инференс становится доминирующей статьей расходов в enterprise-сегменте, и цель серии D — сделать масштабирование экономически оправданным.
Отказ от HBM в пользу колоссального пула LPDDR5X (480 ГБ) в рамках стандартного термопакета 350 Вт дает компаниям возможность запускать модели с триллионными параметрами в обычных серверных стойках без многомиллионных инвестиций в жидкостное охлаждение. Однако массовое применение чипов LPDDR5X для дата-центров может усилить дефицит памяти на потребительском рынке электроники.
Гоняем похожие решения на LPDDR5X в тестах инференса: 480 ГБ без геморроя с СЖО — это реально спасение для серверных стоек. Но учтите, что OneAPI все еще местами капризничает со специфичными квантованными сетками, оптимизация занимает время. Советую сразу настраивать vLLM с бэкендом OpenVINO, тогда задержки минимальны.
Решение поставить LPDDR5X вместо привычной HBM выглядит смело и практично для удешевления инференса. Интересно, насколько задержки памяти скажутся на генерации первых токенов в реальных тестах? И как OneAPI покажет себя в оптимизации под триллионные модели по сравнению с CUDA?