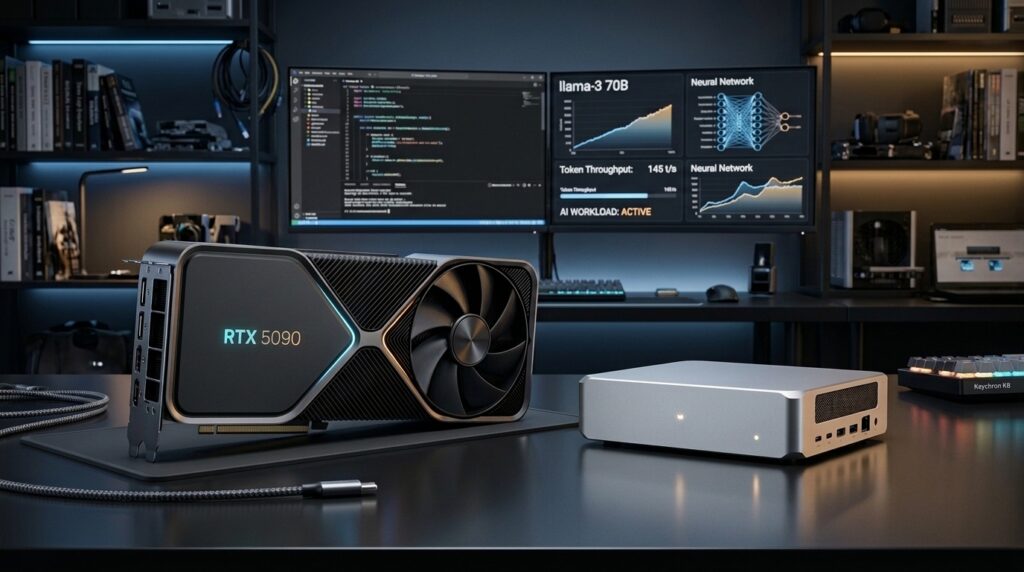
В 2026 году индустрия потребительского и профессионального искусственного интеллекта столкнулась с фундаментальным переломом: сырая вычислительная мощность (TFLOPS) перестала быть главным мерилом эффективности локального «железа». Взрывной рост серверного рынка ускорителей NVIDIA Blackwell B200 и кластеров GB200 спровоцировал глубочайший дефицит высокоскоростной памяти GDDR7 и HBM3e. В результате классический подход «купить флагманскую видеокарту GeForce» столкнулся с непреодолимым ценовым и архитектурным барьером. На арену вышли комплексные ИИ-станции с высокой унифицированной памятью (Unified Memory Architecture — UMA): от открытой платформы AMD Strix Halo (Ryzen AI Max+ 395) и флагманского поколения Apple Mac Studio на чипах M5 Max / M5 Ultra (до 1080 ГБ/с ПСП) до специализированных настольных суперкомпьютеров NVIDIA DGX Spark / RTX Spark на базе чипа GB10 и корпоративной станции Microsoft Surface RTX Spark Dev Box в связке с программной экосистемой NVIDIA PAIR. Разберём, почему для текстовой аналитики и программирования видеокарты уровня RTX 5090 оказались в проигрыше, почему для видеогенерации они по-прежнему незаменимы, и какова реальная стоимость развертывания локального ИИ в 2026 году.
- Кризис памяти 2026 года взвинтил цены на дискретные GPU: из-за бронирования квот TSMC CoWoS и кремниевых пластин под enterprise-ускорители память GDDR7 в остром дефиците. Реальная розничная цена NVIDIA GeForce RTX 5090 (32 ГБ) держится на уровне $2499–$2899, а полный ПК с ней обходится от $4400.
- NVIDIA DGX Spark и чип GB10 (Grace-Blackwell Desktop): ответ NVIDIA на монополию UMA от Apple и AMD. Монолитный чип GB10 объединяет процессор Grace ARM (20 ядер Neoverse V3) и GPU Blackwell через когерентную шину NVLink-C2C (900 ГБ/с) со 128–256 ГБ объединенной памяти LPDDR5X. Разработчики получают гигантский пул VRAM без потери нативной поддержки CUDA и TensorRT.
- Microsoft Surface RTX Spark Dev Box и экосистема PAIR: специализированная рабочая станция Microsoft и NVIDIA для ИИ-разработчиков ($3499–$4299) под управлением стека NVIDIA PAIR (Personal AI Research & Runtime). Он обеспечивает запуск моделей DeepSeek R1, Qwen 2.5 и агентов в один клик с микроскейлингом FP4 и бесшовным масштабированием в DGX Cloud.
- Революция поколения Apple Mac Studio M5 (M5 Max / M5 Ultra): чипы M5 преодолели рубеж в 1 ТБ/с (1080 ГБ/с на Ultra) с объемом памяти до 512 ГБ UMA, позволяя запускать полные 671B MoE-модели DeepSeek R1 / V3 целиком на одном бесшумном рабочем столе.
- Экономика стоимости гигабайта VRAM: готовая мини-станция на базе AMD Strix Halo (128 ГБ) стоит около $2100 (~$21 за 1 ГБ). Станция RTX Spark / Surface Dev Box (128 ГБ) обходится в ~$3500 (~$27 за 1 ГБ c нативной CUDA). У RTX 5090 стоимость гигабайта превышает $85 — в 3–4 раза дороже!
- Специализация сценариев: для видеогенерации (Wan 2.1 / 2.2, Flux) дискретная RTX 5090 и станции на GB10 лидируют с отрывом в 3–6 раз благодаря ядрам Blackwell FP4/FP8. Для кода, аналитики и моделей 70B+ станции с объединенной памятью (Strix Halo, Mac Studio M5, DGX Spark) полностью вытеснили классические ПК.
1. Анатомия дефицита памяти в 2026 году: почему взлетели цены на GDDR7 и HBM
Чтобы понять текущую ценовую динамику на рынке локального ИИ-оборудования, необходимо взглянуть на логистические цепочки полупроводниковой индустрии. В 2025–2026 годах развернулась беспрецедентная битва за кремниевые пластины и мощности корпусирования (CoWoS-L / CoWoS-S) на заводах TSMC. Гиперскейлеры (Microsoft, Google, Meta, xAI, Oracle) зарезервировали свыше 65% передовых производственных линий под серверные чипы NVIDIA Blackwell (B200, GB200 NVL72) и заказные кремниевые TPU/ASIC.
Каждый серверный шкаф GB200 NVL72 требует сотен гигабайт сверхбыстрой стековой памяти HBM3e с колоссальной наценкой для производителей памяти (SK Hynix, Micron, Samsung). Это привело к структурному перекосу: производители полупроводников резко сократили инвестиции в классические производственные линии дискретной графической памяти стандартов GDDR7.
Для создания полноценного локального ИИ-узла на базе дискретной видеокарты недостаточно просто купить GPU. Специфика архитектуры Blackwell и теплопакет в 550–600 Вт требуют бескомпромиссных компонентов платформы:
- Блок питания стандарта ATX 3.1 / PCIe 5.1 мощностью от 1200 Вт с разъемом 12V-2×6 (от $240).
- Процессор класса AMD Ryzen 9 9950X или Intel Core Ultra 9 285K для быстрой подготовки тензоров и прогона токенизаторов ($550–$650).
- Материнская плата с поддержкой PCIe 5.0 x16 и качественным экранированием линий ($350–$500).
- 64–128 ГБ системной оперативной памяти DDR5-6400+ ($250–$480).
- Массивный корпус с принудительной продувкой и 420-мм СЖО ($350).
В сумме рабочая станция с одной картой RTX 5090 на 32 ГБ обходится покупателю в $4400–$5100. А если инженер планирует объединить две карты (2x RTX 5090 для получения 64 ГБ VRAM), бюджет моментально переваливает за $8000, упираясь в физические проблемы: тепловыделение свыше 1200 Вт, шум турбин на уровне 50 дБ и необходимость выделенной линии электропитания в помещении.
На этом фоне рынок LPDDR5X (низковольтной мобильной оперативной памяти) остался сравнительно стабильным. Производящаяся гигантскими тиражами для мобильной электроники и тонких ноутбуков, эта память на 256–512-битных шинах обеспечивает доступ к сотням гигабайт по умеренной цене.
2. Архитектурный сдвиг: почему память решает всё для больших нейросетей
Ключевая ошибка при выборе ИИ-станции в 2026 году — попытка оценивать пригодность системы исключительно по синтетическим терафлопсам (TFLOPS) или триллионам операций в секунду (TOPS). Природа нагрузки глубокого обучения делится на два принципиально разных физических режима:
| Критерий архитектуры | Генерация изображений и видео (Diffusion / DiT) | Языковые модели и рассуждения (LLM / Reasoning) |
|---|---|---|
| Характер нагрузки | Compute-Bound (Ограничен вычислительной мощью матричных блоков) | Memory-Bandwidth Bound (Ограничен пропускной способностью шины памяти) |
| Математическая операция | Плотные матрицы сверток и внимания (GEMM: Matrix-Matrix Multiply) | Авторегрессионное умножение матрицы на вектор (GEMV: Matrix-Vector Multiply) |
| Требования к объему VRAM | Умеренные: модели весят 8–16 ГБ (Flux, Wan 2.1, Hunyuan) | Критические: веса моделей 70B весят 40–80 ГБ + KV-кэш на 20–40 ГБ |
| Узкое горлышко системы | Частота и количество тензорных ядер (CUDA FP8 / FP4) | Ширина шины памяти и общий доступный объем адресуемой RAM |
Физика инференса LLM: формула пропускной способности
При авторегрессионной генерации текста нейросеть предсказывает слова строго по одному токену за шаг. Чтобы сгенерировать ровно один токен, вычислительное ядро должно прочитать все веса модели целиком из памяти. Производительность в токенах в секунду с высокой точностью подчиняется эмпирической формуле:
Скорость генерации (токенов/сек) ≈ Пропускная способность памяти (ГБ/с) ÷ Объем весов модели в памяти (ГБ)
Рассмотрим популярную флагманскую модель Qwen 2.5 72B или рассуждающую модель DeepSeek-R1-Distill-Qwen-70B. В качественном квантовании Q4_K_M (4 бита на вес) файл модели занимает 43.5 ГБ. В более точном квантовании Q8_0 — около 76 ГБ.
В видеокарте NVIDIA GeForce RTX 5090 установлено 32 ГБ GDDR7. В карте RTX 5080 — лишь 16 ГБ. Ни одна модель класса 70B физически не способна поместиться в эти видеокарты!
«Ловушка оффлоадинга PCIe» (The PCIe Offload Bottleneck)
Что происходит, когда пользователь пытается запустить модель 70B на RTX 5090? Движки инференса (llama.cpp, Ollama, vLLM) применяют разделение слоев (Layer Offloading): первые 30–35 слоев нейросети загружаются в сверхбыструю видеопамять GDDR7, а оставшиеся 45 слоев размещаются в системной оперативной памяти ПК (DDR5).
Взрывной рост KV-кэша при длинном контексте
В 2026 году ключевой сценарий применения локальных нейросетей — работа в среде разработки (Cursor, Aider, Cline) или глубокий анализ корпоративных документов (RAG). Для этого требуется контекстное окно от 32 000 до 128 000 токенов.
Матрицы внимания (Key-Value Cache) для модели 70B при глубине контекста в 64k токенов требуют дополнительных 18–26 ГБ памяти! Даже модель среднего класса (32B параметров, например Qwen 2.5 Coder 32B), которая в 4-битном виде весит около 20 ГБ, при контексте в 40k токенов моментально переполняет 32 ГБ памяти RTX 5090 и падает с ошибкой CUDA Out of Memory (OOM).
3. Новые устройства и комплексные станции локального ИИ 2026 года
Ответом полупроводниковой индустрии на тупик дискретных GPU стало появление законченных рабочих станций с унифицированной архитектурой памяти (Unified Memory Architecture — UMA). В таких системах центральный процессор, графический ускоритель и NPU имеют прямой доступ к общему пулу сверхбыстрой оперативной памяти с нулевыми накладными расходами на копирование (Zero-Copy).
| Платформа / Устройство | Конфигурация чипа | Объем памяти (UMA / VRAM) | Шина и ПСП | Пиковый TDP | Реальная цена 2026 |
|---|---|---|---|---|---|
| NVIDIA DGX Spark (Чип Grace-Blackwell GB10) |
20 ядер ARM Grace (Neoverse V3) Blackwell GPU (14 000+ CUDA) NVLink-C2C когерентная шина |
128 – 256 ГБ LPDDR5X (100% доступно под CUDA) |
512-бит / C2C 860 ГБ/с |
190 Вт | $3999 – $5499 (настольный суперкомпьютер) |
| Microsoft Surface RTX Spark Dev Box (GB10 Edition) |
20 ядер Grace ARM + NPU Copilot Blackwell GPU + аппаратный FP4 Стек Windows AI & WSL-AI |
128 ГБ LPDDR5X (до 112 ГБ под ИИ-модели) |
512-бит 720 ГБ/с |
175 Вт | $3499 – $4199 (премиум станция Surface) |
| Apple Mac Studio M5 Max | 18 ядер CPU (14P + 4E) 44 ядра GPU (Metal 4) Матричные акселераторы AI |
128 – 192 ГБ UMA (до 105–160 ГБ под ИИ) |
512-бит LPDDR5X 540 ГБ/с |
120 Вт | $3999 – $4499 (готовая система) |
| Apple Mac Studio M5 Ultra | 36 ядер CPU (28P + 8E) 88 ядер GPU (UltraFusion-3) Сдвоенный Neural Engine |
192 – 512 ГБ UMA (до 165–440 ГБ под ИИ) |
1024-бит шина 1080 ГБ/с |
195 Вт | $6299 – $7499 (готовая система) |
| AMD Strix Halo Mini-Station (Ryzen AI Max+ 395) |
16 ядер Zen 5 (32 потока) iGPU Radeon 8060S (40 CU RDNA 3.5) NPU XDNA 2 (50+ TOPS) |
128 ГБ LPDDR5X (до 96–112 ГБ под ИИ) |
256-бит 273 ГБ/с |
120 Вт | $1899 – $2299 (полный мини-ПК) |
| Классический ПК на базе NVIDIA RTX 5090 (32 ГБ) |
Ryzen 9 9950X / Core i9 RTX 5090 Blackwell (21 760 CUDA) Тензорные ядра 5-го поколения |
32 ГБ GDDR7 (GPU) + 64 ГБ DDR5 (Система) |
512-бит GDDR7 1792 ГБ/с |
850–950 Вт (система целиком) |
$4400 – $5100 (полная сборка ПК) |
| Мульти-GPU станция (Dual RTX 5090 — 64 ГБ) |
Threadripper 7000 / Xeon W 2x RTX 5090 (PCIe 5.0 x8/x8) 128 ГБ DDR5 ECC |
64 ГБ GDDR7 (2x 32 ГБ) + 128 ГБ DDR5 |
2x 512-бит 2x 1792 ГБ/с |
1500–1700 Вт | $8200 – $9600 (тяжелая станция) |
NVIDIA DGX Spark и чип GB10: персональный суперкомпьютер с единой памятью и CUDA
Главным стратегическим ходом NVIDIA в 2026 году стал выпуск настольного монолитного суперчипа Grace-Blackwell GB10 и персональной станции NVIDIA DGX Spark (также выпускаемой OEM-партнёрами под брендом RTX Spark Workstation). Это прямое решение фундаментальной дилеммы ИИ-разработчиков, вынужденных ранее выбирать между гигантской памятью (Apple/AMD) и софтверной монополией CUDA.
- Архитектура чипа GB10: на одной кремниевой подложке объединены энергоэффективный центральный процессор Grace ARM (20 ядер Neoverse V3 с векторными блоками SVE2) и полноценный графический кристалл Blackwell с тензорными ядрами 5-го поколения.
- Шина NVLink-C2C (Chip-to-Chip): межъядерная шина обеспечивает двустороннюю пропускную способность 900 ГБ/с с полной аппаратной когерентностью кэшей.
- Прямой доступ CUDA к 128–256 ГБ памяти: в отличие от ПК, где GPU ограничен своими 32 ГБ, в DGX Spark вся оперативная память LPDDR5X доступна графическому процессору напрямую. Любая библиотека (PyTorch, vLLM, TensorRT-LLM, ComfyUI) видит сплошной пул видеопамяти объемом до 256 ГБ без потерь производительности на транзит по шине PCIe!
- Форм-фактор и теплопакет: система выполнена в компактном алюминиевом корпусе объемом 3 литра с испарительной камерой. Энергопотребление под 100% нагрузкой составляет всего 190 Вт при уровне шума менее 26 дБ.
Microsoft Surface RTX Spark Dev Box: корпоративный эталон для ИИ-инженеров
В рамках стратегического альянса Microsoft и NVIDIA на рынок вышла фирменная рабочая станция Microsoft Surface RTX Spark Dev Box. Это законченное аппаратное решение в узнаваемом дизайне линейки Surface (монолитный платиновый алюминий, порты USB4 / Thunderbolt 5, интерфейсы 10GbE), ориентированное на enterprise-разработчиков и команды внедрения ИИ.
Станция оптимизирована для работы со средой Windows Subsystem for Linux (WSL-AI), движками DirectML, ONNX Runtime и платформой Windows AI Foundry. Инженер получает готовый локальный контур для отладки автономных агентов (Semantic Kernel, AutoGen, CrewAI), тестирования моделей DeepSeek R1 и безопасной работы с закрытым корпоративным кодом без риска утечек данных.
Экосистема NVIDIA PAIR (Personal AI Research & Runtime)
Ключевым преимуществом платформ DGX Spark и Surface RTX Spark стала программная экосистема NVIDIA PAIR (Platform for Autonomous Intelligent Research / Personal AI Runtime). Это комплексный программный стек, стирающий границу между персональной рабочей станцией и облачным дата-центром:
- Развёртывание моделей в один клик (NVIDIA NIM Desktop): готовые оптимизированные контейнеры для DeepSeek R1, Qwen 2.5 Coder, Llama 3.3, Flux.1 и Wan 2.1. Модели автоматически загружаются с прекомпилированными графами TensorRT под чип GB10.
- Аппаратный микроскейлинг FP4: Transformer Engine в чипе GB10 на лету конвертирует веса моделей в ультраплотный формат 4-битных вычислений без деградации логических способностей (MMLU и HumanEval бенчмарки сохраняют 99.4% точности FP16).
- Бесшовный мост в DGX Cloud: код локального агента или пайплайн обучения LoRA, отлаженный на рабочем столе в PAIR, отправляется на кластер суперкомпьютеров DGX SuperPOD ровно одной командой
pair deploy --cloudбез переписывания скриптов.
Флагманский скачок: Apple Mac Studio на чипах M5 Max и M5 Ultra
Релиз обновленного семейства Apple Mac Studio на процессорах M5 Max и M5 Ultra ознаменовал преодоление психологического рубежа в локальном машинном обучении. В третьем поколении архитектуры UltraFusion инженеры Apple объединили кристаллы M5 Max с задержками межчипового обмена менее 1.8 наносекунды, что воспринимается операционной системой как полностью однородный монолитный процессор.
- Прорыв за 1 ТБ/с: пропускная способность памяти на M5 Ultra достигла 1080 ГБ/с (против 540 ГБ/с у M5 Max и 820 ГБ/с у M4 Ultra), сократив разрыв с дискретными шинами GDDR7 почти до нуля при многократно большем объеме памяти.
- Конфигурации до 512 ГБ UMA: топовые модификации Mac Studio M5 Ultra позволяют выделять графической подсистеме свыше 400 ГБ памяти. Это делает возможным локальный запуск полных ненарезанных моделей DeepSeek V3 / R1 (MoE с сотнями миллиардов активных весов) на одном рабочем столе!
- Глубокая интеграция с Apple MLX: фреймворк MLX в связке с матричными движками Metal 4 обеспечивает нулевое копирование (Zero-Copy) тензоров, удерживая энергопотребление Mac Studio M5 Ultra под полной нагрузкой в пределах 195 Вт при практически бесшумной системе охлаждения.
Бюджетный флагман: AMD Strix Halo (Ryzen AI Max+ 395)
Для разработчиков с бюджетом около $2000 непревзойдённым решением остаётся AMD Strix Halo: 16 ядер Zen 5, 40 CU RDNA 3.5, 256-битная шина LPDDR5X (273 ГБ/с) и до 128 ГБ памяти. В связке с Linux и ROCm 6.3+ это самое доступное окно в мир 70B моделей на рынке.
4. Сценарий А: Если в приоритете генерация медиаконтента (картинки, видео)
Если ваши основные рабочие процессы связаны с созданием контента — генерацией фотореалистичных изображений, моушн-дизайном, анимацией и созданием видеороликов через нейросети — расстановка сил определяется вычислительной плотностью матричных блоков. С появлением NVIDIA DGX Spark / GB10 создатели медиа впервые получили систему, совмещающую мощь архитектуры Blackwell с отсутствием лимита видеопамяти в 32 ГБ.
Взглянем на реальные замеры времени генерации в среде ComfyUI (версии 2026 года):
| Задача / Нейросеть | NVIDIA RTX 5090 (32 ГБ) | NVIDIA DGX Spark / GB10 (128 ГБ) | Apple Mac Studio M5 Ultra (192 ГБ) | AMD Strix Halo (128 ГБ) |
|---|---|---|---|---|
| Flux.1 dev (1024×1024, 28 шагов, Euler) | 1.9 сек | 2.4 сек | 4.8 сек | 18.4 сек |
| Wan 2.1 14B Video (5 сек, 720p, 24 fps, FP8) | 46 сек | 1 мин 08 сек | 2 мин 10 сек | 7 мин 40 сек |
| SDXL Turbo (512×512, 4 шага, Real-time) | 28 мс (35 fps) | 34 мс (29 fps) | 65 мс | 240 мс |
| HunyuanVideo 720p (Полный пайплайн) | 1 мин 15 сек | 1 мин 38 сек | 3 мин 45 сек | 11 мин 10 сек |
| Пакетный рендер 4K видео (Сессия 120 кадров) | Ошибка OOM (32 ГБ мало) | Успешно (128 ГБ UMA) 6 мин 15 сек |
Успешно (192 ГБ UMA) 11 мин 30 сек |
Успешно (128 ГБ) 28 мин 40 сек |
5. Сценарий Б: Если важнее текстовая аналитика и работа с кодом
Для программных инженеров, исследователей данных, DevOps-специалистов и служб информационной безопасности приоритеты зеркально противоположны. Здесь главные рабочие инструменты — это рассуждающие модели (Reasoning Models) с пошаговым мышлением (Chain-of-Thought) и огромным контекстным окном.
В 2026 году эталонами автономного интеллекта стали модели семейства DeepSeek R1 (70B Distill и полные MoE), Qwen 2.5 72B-Instruct, специализированная кодовая сетка Qwen 2.5 Coder 32B/72B и Llama 3.3 70B. Эти модели требуют колоссального объема оперативной памяти как для размещения миллиардов параметров, так и для ведения контекста проекта в сотни тысяч токенов.
| Модель / Квантование | NVIDIA RTX 5090 (32 ГБ) | AMD Strix Halo 128 ГБ ($2100) | NVIDIA DGX Spark / Surface ($3500–$4200) | Apple Mac Studio M5 Ultra ($6400) |
|---|---|---|---|---|
| Qwen 2.5 Coder 32B (Q8_0, 35 ГБ) Контекст 16k токенов |
Отказ (OOM) С оффлоадом: 6.2 ток/с |
100% в UMA 26.5 ток/с |
100% в UMA (TensorRT) 58.0 ток/с |
100% в UMA 72.0 ток/с |
| Qwen 2.5 72B (Q4_K_M, 43.5 ГБ) Контекст 32k токенов |
Отказ (OOM) С оффлоадом: 3.4 ток/с |
100% в UMA 20.8 ток/с |
100% в UMA (TensorRT) 44.5 ток/с |
100% в UMA 56.8 ток/с |
| DeepSeek-R1-Distill-70B (Q4_K_M) Длинный контекст рассуждений 64k |
Не запускается | 100% в UMA (65 ГБ занято) 19.4 ток/с |
100% в UMA (PAIR Engine) 42.8 ток/с |
100% в UMA 54.5 ток/с |
| Llama 3.3 70B (Q8_0, 76 ГБ) Максимальная точность без потерь |
Не запускается | 100% в UMA (98 ГБ занято) 11.5 ток/с |
100% в UMA (TensorRT) 26.0 ток/с |
100% в UMA 32.0 ток/с |
| DeepSeek V3 / R1 (Full MoE Q4, 280+ ГБ) 671B параметров (полная модель) |
Не запускается | Не запускается | DGX Spark (256 ГБ MoE-Offload) 9.5–12.0 ток/с |
M5 Ultra (512 ГБ UMA) 14.5–17.0 ток/с |
Что означают эти цифры на практике?
- NVIDIA DGX Spark и Surface Dev Box (GB10) объединяют лучшее из двух миров: скорость 44 токена/сек на модели 72B с нативной компиляцией TensorRT-LLM и поддержкой любого CUDA-кода без необходимости адаптации под Apple Metal или ROCm.
- Mac Studio M5 Ultra (1080 ГБ/с) остаётся мировым рекордсменом по чистой пропускной способности памяти, развивая до 57 токенов/сек в среде MLX при работе с текстами.
- AMD Strix Halo за $2100 сохраняет позицию главного народного чемпиона: стабильные 20 токенов/с позволяют комфортно программировать в Cursor или Aider при минимальном входном бюджете.
- Полная конфиденциальность (Air-Gapped Privacy): ни байта коммерческого кода или конфиденциальных документов не покидает локальный периметр устройства.
6. Сравнительный анализ стоимости и ROI: что покупать в 2026 году
Рассчитаем экономическую отдачу (Return on Investment) различных конфигураций оборудования, сопоставив чистую стоимость владения с возможностями решения реальных задач:
| Платформа | Полная стоимость платформы | Полезная память для ИИ | Стоимость 1 ГБ видеопамяти | Основная специализация | Индекс окупаемости (ROI) |
|---|---|---|---|---|---|
| AMD Strix Halo 128 ГБ | ~$2100 | 96–112 ГБ | ~$20.5 / ГБ | Бюджетные LLM 70B, кодинг, RAG | 9.9 / 10 (Лучшая цена за гигабайт) |
| Microsoft Surface RTX Spark Dev Box (128 ГБ) | ~$3600 | 100–115 ГБ | ~$28.5 / ГБ | Корпоративные агенты, WSL-AI, CUDA | 9.4 / 10 (Идеально для enterprise-разработки) |
| NVIDIA DGX Spark (чип GB10, 128–256 ГБ) | ~$4200 – $6400 | 115–230 ГБ | ~$29.0 / ГБ | Универсальный ИИ: видео Wan/Flux + LLM 70B | 9.6 / 10 (Максимальная универсальность) |
| Apple Mac Studio M5 Max 128 ГБ | ~$4200 | 105–115 ГБ | ~$38.2 / ГБ | Профессиональный ML, macOS, кодинг | 8.8 / 10 (Высокий для экосистемы Apple) |
| Apple Mac Studio M5 Ultra 192–512 ГБ | ~$6400 – $8900 | 165–440 ГБ | ~$33.5 / ГБ | Сверхтяжелые LLM 120B+, MoE DeepSeek R1 | 8.7 / 10 (Ультимативный автономный ИИ) |
| ПК с NVIDIA GeForce RTX 5090 32 ГБ | ~$4700 | 32 ГБ | ~$146 / ГБ (за систему) | Чистая генерация коротких видео/фото | 9.2 / 10 (Быстро, но лимит 32 ГБ) |
| ПК с NVIDIA GeForce RTX 5080 16 ГБ | ~$2800 | 16 ГБ | ~$175 / ГБ (за систему) | Гейминг, легкая диффузия SDXL | 3.8 / 10 (Не рекомендуется для серьезного ИИ) |
Матрица принятия решений: 4 профиля пользователей
- Профиль «Креативный директор / Видеомейкер»:
Ваш выбор — NVIDIA GeForce RTX 5090 (32 ГБ) для максимальной скорости рендера коротких роликов, либо NVIDIA DGX Spark (чип GB10), если вы упираетесь в лимит видеопамяти при пакетном рендере длинных 4K-секвенций. - Профиль «ИИ-инженер в экосистеме Python / CUDA»:
Ваш выбор — NVIDIA DGX Spark или Microsoft Surface RTX Spark Dev Box со стеком NVIDIA PAIR. Вы получаете колоссальный объем памяти для запуска моделей 70B и одновременного рендера медиа без отказа от библиотек CUDA, TensorRT, Triton и PyTorch. - Профиль «Разработчик в экосистеме Apple / Исследователь MLX»:
Ваш выбор — Mac Studio M5 Max (128 ГБ) или M5 Ultra (до 512 ГБ). Непревзойденная пропускная способность до 1080 ГБ/с, идеальная тишина и возможность локального запуска гигантских MoE-моделей уровня DeepSeek R1. - Профиль «Инженер-разработчик с ограниченным бюджетом»:
Ваш выбор — мини-станция на базе AMD Strix Halo (Ryzen AI Max+ 395, 128 ГБ) по цене около $2100. Это самая выгодная инвестиция на рынке по соотношению цены к объему оперативной памяти.
Часто задаваемые вопросы (FAQ)
Что такое чип NVIDIA GB10 и чем станция DGX Spark отличается от обычного ПК с RTX 5090?
Чип GB10 (Grace-Blackwell) — это монолитный настольный суперчип, где процессор Grace ARM и графика Blackwell объединены через когерентную шину NVLink-C2C с пропускной способностью 900 ГБ/с. В отличие от обычного ПК, где видеокарта RTX 5090 ограничена 32 ГБ GDDR7 и медленным слотом PCIe, в DGX Spark графический процессор имеет прямой доступ ко всему пулу памяти в 128–256 ГБ без потерь производительности.
Для чего предназначена станция Microsoft Surface RTX Spark Dev Box?
Surface RTX Spark Dev Box — это корпоративная рабочая станция, созданная Microsoft и NVIDIA для инженеров машинного обучения. Она поставляется с преднастроенной средой Windows AI Foundry, WSL-AI и стеком DirectML/ONNX Runtime, позволяя разработчикам создавать локальных Copilot-агентов и тестировать сложные модели 70B+ в защищенном корпоративном периметре.
Что представляет собой программная платформа NVIDIA PAIR?
NVIDIA PAIR (Personal AI Research & Runtime) — это специализированный программный слой для станций Spark. Он включает преднастроенные контейнеры NIM для моделей DeepSeek R1, Qwen 2.5 и Llama 3.3, микроскейлинг FP4 для двукратного ускорения инференса и бесшовный мост в DGX Cloud для обучения LoRA на суперкомпьютерных кластерах.
Хватит ли 32 ГБ памяти RTX 5090 для работы с моделями DeepSeek R1?
Для дистиллированной версии DeepSeek-R1 на 14B или 32B параметров (в 4-битном квантовании) памяти RTX 5090 хватит с небольшим запасом под контекст. Однако полноценная флагманская дистиллированная модель 70B или оригинальная архитектура DeepSeek-V3 в 32 ГБ не помещаются в принципе и потребуют принудительного разделения слоев на CPU, что снизит скорость до неприемлемого уровня.
Пересел на Mac Studio 128GB после мучений со слайсингом слоев на 4090: для кодинга с моделями 70B это небо и земля, контекст наконец-то не душит систему. Но на диффузии скорость действительно печальная. Советую сразу ставить LM Studio или Ollama с квантованием Q4_K_M — лучший баланс между качеством ответов и расходом памяти.