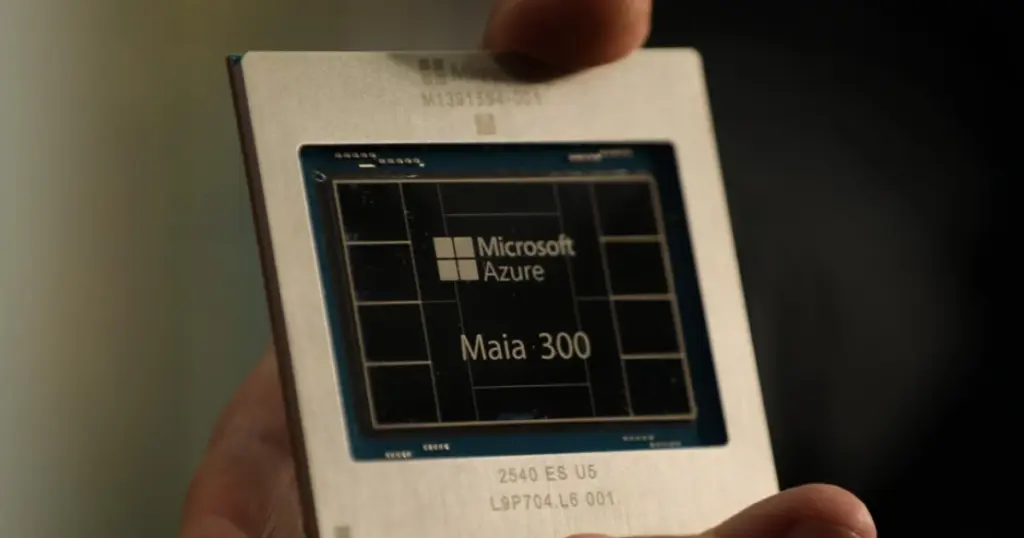
- Microsoft презентовала свой ИИ-чип третьего поколения Maia 300 на базе 2-нм чиплетной архитектуры.
- Процессор позиционируется как ключевая система инференса для внутренних сервисов и продуктов корпорации.
- Развертывание ускорителя в облачной инфраструктуре запланировано на 2027 год.
Новый шаг к аппаратной независимости
Корпорация Microsoft официально представила собственный ускоритель вычислений третьего поколения — Maia 300. Чип разработан с прицелом на существенное сокращение зависимости инфраструктуры компании от графических процессоров Nvidia. Новинка позиционируется как главная аппаратная платформа для выполнения инференса (inference) во всей экосистеме сервисов Microsoft.
Особенности архитектуры и ключевые задачи
В основу Maia 300 легла передовая 2-нм чиплетная компоновка. По заявлениям разработчиков, аппаратный комплекс нацелен на оптимизацию затрат и значительное повышение энергоэффективности облачных вычислений. Особое внимание при проектировании уделялось обработке передовых моделей с функциями логического рассуждения (reasoning), а также инфраструктуре автономных ИИ-агентов.
| Параметр | Характеристики Microsoft Maia 300 |
|---|---|
| Поколение | 3-е поколение собственных ИИ-чипов Maia |
| Техпроцесс | 2 нм (чиплетная архитектура) |
| Основное назначение | Инференс нейросетей, агентные сценарии, рассуждающие модели |
| Старт внедрения | 2027 год |
| Ключевая цель | Снижение зависимости от GPU Nvidia, оптимизация облачных затрат |
Полномасштабный ввод ускорителей в эксплуатацию в ЦОД намечен на 2027 год, что позволит планомерно перевести рабочие нагрузки облачных сервисов на собственную компонентную базу.
Для индустрии облачных сервисов переход Microsoft на собственные кремниевые решения знаменует усиление конкуренции на рынке специализированных ускорителей и ослабление монополии традиционных поставщиков GPU. Для конечных пользователей это потенциально обеспечит более стабильную и экономически эффективную работу фирменных ИИ-инструментов компании.
Тестировали кастомные инференс-чипы в облаке: со стандартными LLM они работают отлично и заметно срезают косты, но под кастомные фреймворки компиляторы пока сырые. Советую заранее закладывать время на оптимизацию графов вычислений под ONNX/Triton, иначе до половины производительности просто теряется.