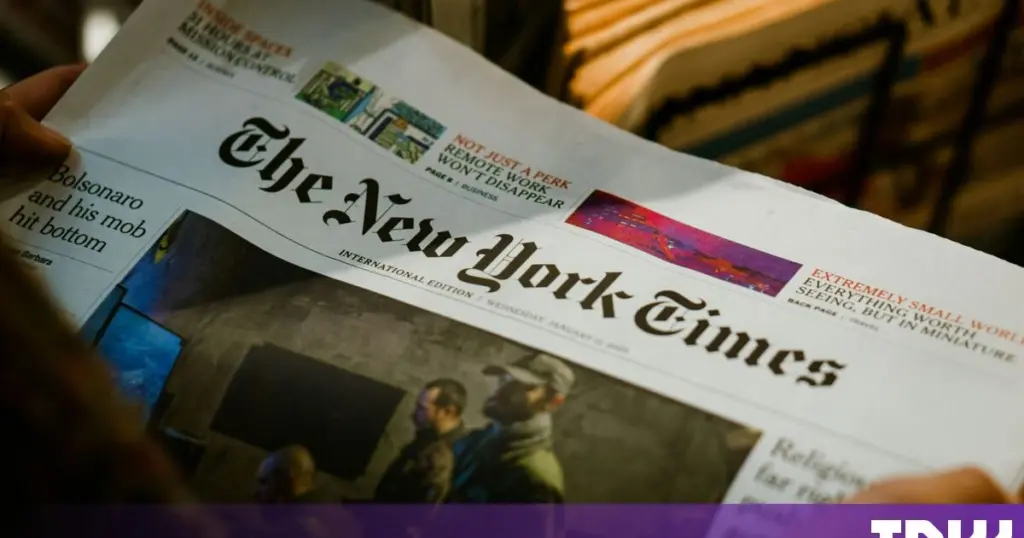
- The New York Times и другие крупные издатели подали иски против Brave Software, обвиняя компанию в незаконном сборе контента.
- Brave обвиняется в обходе платных стен и продаже доступа к журналистским материалам для обучения ИИ-моделей.
- Истцы утверждают, что Brave заработала более 100 миллионов долларов, перепродавая контент без согласия издателей.
Крупные издатели подали в суд на Brave Software
The New York Times и три других крупных американских издания - New York Daily News, Chicago Tribune и Orlando Sentinel - подали иски против разработчика веб-браузера Brave, компании Brave Software. Иски, поданные в федеральный суд, обвиняют Brave в незаконном скрапинге журналистских материалов, обходе платных стен и последующей продаже доступа к этому контенту компаниям, занимающимся разработкой искусственного интеллекта.
Обвинения в незаконном сборе и распространении контента
Издатели утверждают, что Brave не только собирает их защищенный авторским правом контент, но и распространяет его своим собственным пользователям, а также продает таким крупным ИИ-компаниям, как Anthropic, Perplexity, Mistral, xAI и Cohere. В иске New York Times говорится, что «Brave является поставщиком, дилером и дистрибьютором украденного контента, защищенного авторским правом, для своих собственных пользователей и многих наиболее известных компаний GenAI».
Согласно заявлению, ИИ-компании платят Brave за предоставление им онлайн-контента в реальном времени из поискового индекса Brave, который затем используется для обучения их моделей ИИ и ответов на запросы пользователей. Веб-сайт Brave Search API подтверждает это, заявляя, что его используют «некоторые из крупнейших имен в ИИ, включая Cohere, Mistral, Perplexity и You.com».
Финансовые претензии и требования
В судебном иске New York Times, ссылаясь на сторонние оценки доходов, утверждается, что Brave «заработала более 100 миллионов долларов, копируя и перепродавая работы издателей без их согласия или разрешения», в то время как «издатели не получили ничего». Истцы требуют от Brave прекратить блокировку платных стен и разорвать все соглашения с ИИ-компаниями, связанные с использованием их контента.
Этот иск подчеркивает растущую напряженность между издателями контента и компаниями, использующими ИИ для обучения своих моделей. Ранее OpenAI запустила программу Grid Protectors, чтобы снизить нагрузку ИИ на энергосети, что также является частью более широкой дискуссии о влиянии ИИ на различные отрасли.
Этот судебный процесс может установить важный прецедент в отношении прав на контент в эпоху искусственного интеллекта. Если издатели одержат верх, это может кардинально изменить способы, которыми ИИ-компании получают данные для обучения, и повлиять на бизнес-модели браузеров, предлагающих обход платных стен. Для пользователей это может означать изменения в доступе к контенту через браузеры, ориентированные на конфиденциальность, и потенциальное увеличение стоимости доступа к высококачественной журналистике.
Иск против Brave поднимает фундаментальные вопросы о правомерности агрегации контента и его последующей монетизации, особенно в контексте обучения ИИ-моделей. Обход paywalls и скрапинг данных, даже если они технически осуществимы, создают серьезные правовые риски, затрагивающие авторские права и бизнес-модели издателей. Этот прецедент может значительно повлиять на регулирование рынка данных для GenAI и, возможно, спровоцирует пересмотр лицензионных соглашений.