- Масштабный сбой облачных сервисов Microsoft 365 начался 12 ноября около 18:00 UTC и продолжается более 15 часов.
- Проблема вызвана перегрузкой основного процесса на серверах, что приводит к сбоям автоматических проверок работоспособности и снижению доступности.
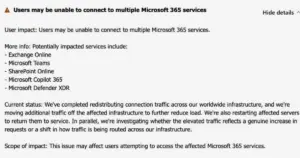
- Затронуты ключевые сервисы, включая Exchange Online, Teams, Copilot 365, Defender for Office 365, Intune, а также административные инструменты.
Обзор масштабного сбоя Microsoft 365
Масштабный сбой в работе облачных сервисов Microsoft 365, начавшийся 12 ноября около 18:00 UTC, продолжает серьезно нарушать работу пользователей по всему миру. Инцидент, который в Австралии уже назвали «долгими выходными Microsoft», затронул основные компоненты инфраструктуры, включая Exchange Online, Teams, Copilot 365 и Defender for Office 365. Администраторы также столкнулись с невозможностью доступа к таким инструментам, как Intune и Microsoft 365 Apps Admin Center, что существенно затрудняет процесс устранения неполадок.
Согласно заявлениям Microsoft, первоначальная причина сбоя была связана с «проблемой, из-за которой серверы не проходят автоматические проверки работоспособности и становятся недоступными». Дальнейшее расследование показало, что основной процесс на затронутых серверах «перегружается», что приводит к их зависанию и потере пропускной способности.
Хронология и предпринимаемые действия
Попытки Microsoft восстановить работу сервисов пока не принесли ожидаемого результата. Изначально компания сообщала о найденном и протестированном альтернативном методе проверки работоспособности, который позволил «некоторой части затронутых серверов успешно вернуться в строй». Однако последующие обновления статуса указывают на сохраняющиеся трудности:
- Применение улучшений пропускной способности инфраструктуры в регионах.
- Мониторинг изменений, которые «не приносят ожидаемого эффекта».
- Анализ потоков трафика и затронутой инфраструктуры для оптимизации маршрутизации.
- Поиск альтернативных подходов для увеличения пропускной способности.
- Частичное восстановление в некоторых регионах, не приводящее к устойчивой стабилизации.
- Проблемы с масштабированием виртуальных машин, которые «зависают в нерабочем состоянии».
На данный момент Microsoft не предоставила точных сроков полного восстановления сервисов. Компания продолжает исследовать «множество направлений работы для выявления основной причины притока трафика и ускорения восстановления серверных систем».
Отсутствие признаков вредоносной активности
В начале инцидента Microsoft изменила формулировку относительно возможной кибератаки. Если сначала говорилось об отсутствии «признаков вредоносной активности», то позднее формулировка стала более конкретной: «По состоянию на 05:46 UTC нам неизвестно о какой-либо вредоносной активности, которая вызывает этот инцидент». Это указывает на то, что компания исключила кибератаку как причину сбоя, сосредоточившись на внутренних технических проблемах. Ранее PROSTO24 уже освещал аналогичные проблемы с сервисами Microsoft.
Затронутые сервисы и влияние
Сбой затрагивает широкий спектр сервисов Microsoft 365, которые взаимодействуют с Exchange Online и почтовыми службами. Среди них:
| Сервис | Описание |
|---|---|
| Exchange Online | Основная почтовая служба |
| Teams | Платформа для совместной работы |
| Copilot 365 | ИИ-помощник |
| Defender for Office 365 | Защита от угроз |
| Intune | Управление конечными точками |
| Microsoft 365 Apps Admin Center | Панель администратора |
| SharePoint Online | Сервис для совместной работы |
| Windows 365 | Облачные ПК |
| Fabric, Graph, Planner, Power Apps, Purview, To Do, Universal Print | Другие облачные службы |
Сообщения о значительном нарушении рабочих процессов поступают из различных стран, включая Великобританию, где государственные учреждения и Национальная служба здравоохранения (NHS) столкнулись с проблемами в отправке и получении электронных писем, а также доступе к онлайн-консультациям для пациентов.
Продолжительный сбой Microsoft 365 подчеркивает риски централизации критически важных бизнес-процессов в одной облачной экосистеме. Для компаний и государственных учреждений это означает необходимость усиления планов аварийного восстановления и рассмотрения альтернативных решений для обеспечения непрерывности операций, особенно для электронной почты и коммуникаций. Отсутствие четких сроков восстановления также указывает на сложность проблемы, с которой столкнулась Microsoft, и потенциальную потребность в более диверсифицированных стратегиях для поддержания работоспособности в условиях масштабных инцидентов.
Подобные масштабные сбои напоминают о критической зависимости от облачных решений. Всегда кажется, что централизованные сервисы надежнее, но на практике их отказ парализует работу тысяч компаний. Насколько вообще оправданы риски при полной миграции в облако, если даже у такого гиганта, как Microsoft, случаются многочасовые простои? Недооцениваются ли здесь потенциальные издержки и сложности быстрого восстановления?